一次点击到底发生了什么?Java 全栈请求从浏览器到 MySQL 的完整链路
学习 Java 全栈时,我们往往会分别接触 Vue、HTTP、Nginx、Spring Boot、Spring MVC、Controller、Service、MyBatis、MySQL、Redis、消息队列等技术。真正困难的并不是记住这些名词,而是理解它们在一个真实项目中如何连接。本文沿着一次真实用户操作,把“打开网站”和“调用后端 API”两条链路串起来:从浏览器、网络、Nginx、Tomcat、Spring MVC,到 Controller、Service、MyBatis、JDBC、MySQL,再返回 Vue 页面;同时把 Redis、MQ、WebSocket、定时任务、安全、事务、异常处理与可观察性放回它们真正所在的位置。
1. 为什么要从“一次请求”重新理解 Java 全栈
很多 Java 学习路线最后会变成一串技术名词:
Java
Spring Boot
Spring MVC
MyBatis
MySQL
Redis
Nginx
Vue
MQ
...
每一个名词单独看都认识,但真正进入项目后,经常会遇到三个问题:
- 它位于整条链路的哪里?
- 它在这里解决什么问题?
- 它的上游和下游分别是谁?
如果只记住:
Vue → Spring Boot → MySQL
这个模型太粗。
如果只记住:
Controller → Service → Mapper
它又只覆盖了 Java 后端内部的一小段。
一个更接近真实工程的视角应该是:
用户
 ↓
浏览器 / 前端
 ↓
网络与 HTTP
 ↓
Nginx / Web Server
 ↓
Tomcat / Servlet
 ↓
Spring MVC
 ↓
Controller / Service / Mapper
 ↓
MyBatis / JDBC
 ↓
MySQL
 ↓
结果返回浏览器
而在这条主链周围,还存在三类能力:
支线能力:Redis / MQ / WebSocket / Spring Task / 第三方服务
横切能力:Security / Validation / Transaction / AOP / Exception / Observability
工程外围:Maven / Git / Test / Linux / Docker / CI/CD / Deployment
所以全文只做三件事:
- 纵向看链路:请求是怎么走的。
- 横向看层级:每一层有哪些技术。
- 横切看能力:哪些机制会跨越多个层。
2. 先分清两件事:打开网站 ≠ 调用后端 API
这是理解整条链路的第一步。
用户第一次在地址栏输入:
https://example.com/admin/employee
和页面已经打开之后点击:
“保存员工”
虽然都会发生网络通信,但它们属于两个不同阶段。
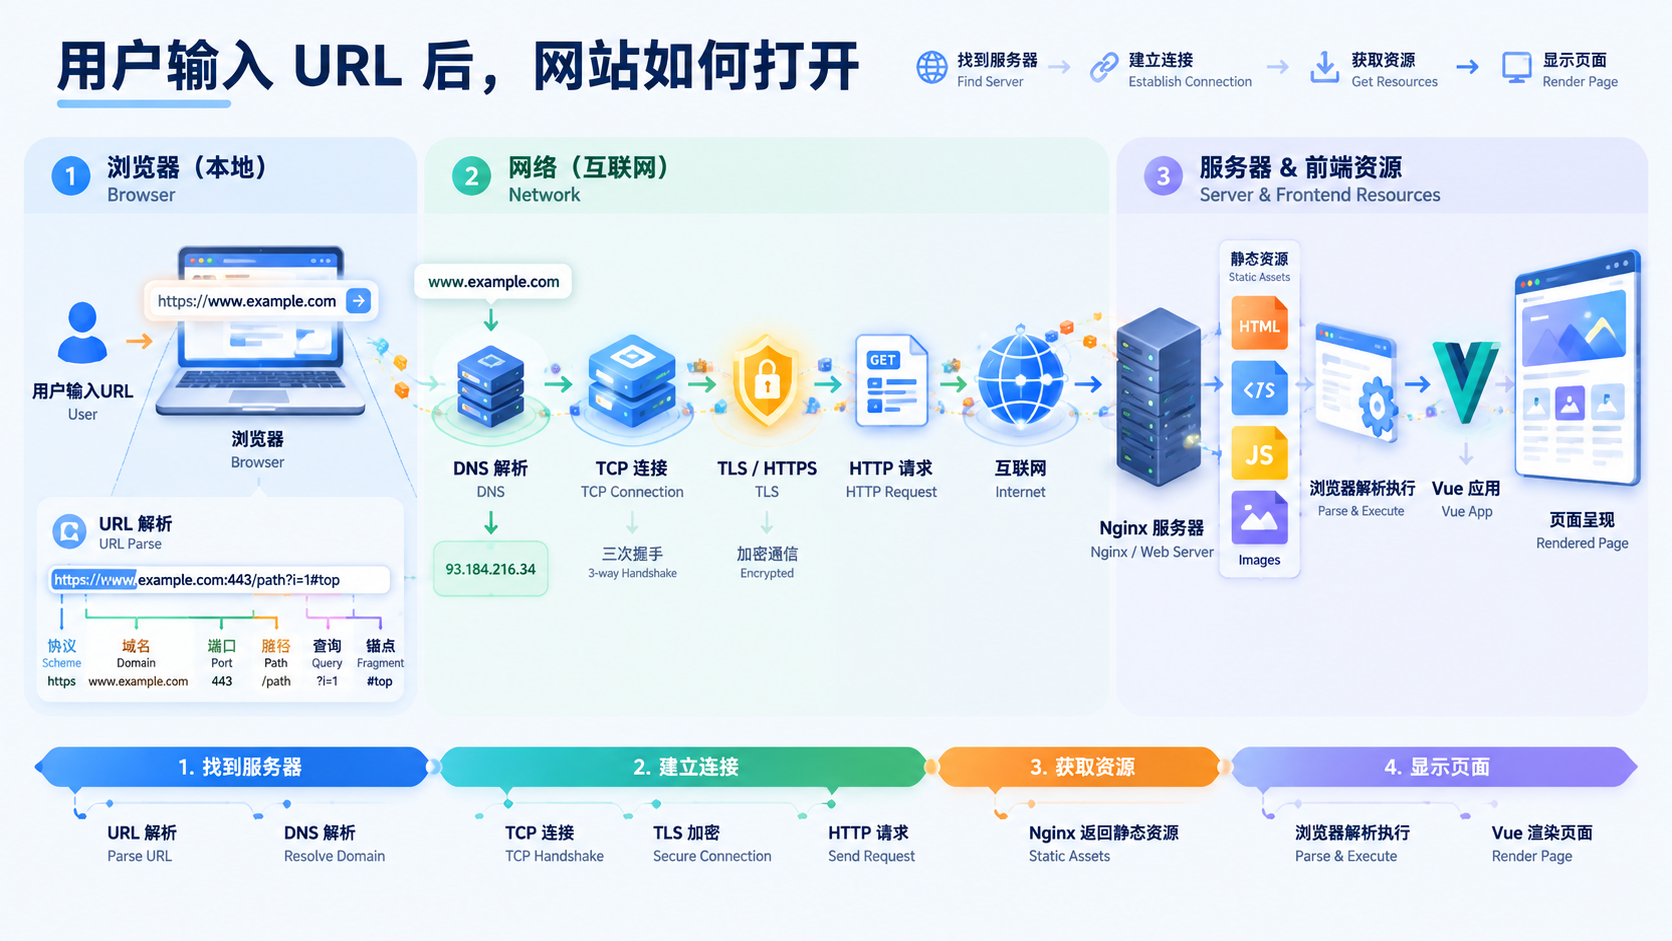
2.1 阶段 A:网站是怎样打开的
为了看清主干,下面先忽略 DNS 缓存、连接复用、CDN、HTTP/2 多路复用等优化细节,并以常见的 HTTP/1.1 或 HTTP/2 over TCP 为例。HTTP/3 使用 QUIC,底层连接过程会有所不同。
用户输入 URL
    ↓
浏览器解析 URL
    ↓
DNS:域名 → IP
    ↓
建立连接
    ↓
HTTPS 场景进行 TLS 握手
    ↓
发送 HTTP Request
    ↓
Nginx / Web Server
    ↓
HTML / CSS / JavaScript / 图片
    ↓
浏览器解析与执行
    ↓
Vue 应用启动
    ↓
页面展示
这一阶段解决的是:
网站页面从哪里来,以及浏览器如何把资源组装成用户看到的页面。
| 层次 | 主要知识点 | 在这里的作用 | | -------- | -------------------------------------------- | -------------------------------- | | 浏览器 | URL、Cache、Cookie、DevTools | 接收用户输入、加载并展示页面 | | 网络 | DNS、IP、Port、TCP / QUIC | 找到服务器并建立通信通道 | | 安全 | TLS、HTTPS、Certificate | 加密通信并验证服务端身份 | | Web 通信 | HTTP Request / Response、Header、Status Code | 定义浏览器与服务器的数据交换方式 | | 网关 | Nginx / CDN / Load Balancer | 静态资源、反向代理、HTTPS 入口等 | | 前端 | HTML、CSS、JavaScript、Vue | 构建最终用户界面 |
需要注意两点:
- Nginx 是常见生产部署节点,不是 Spring MVC 的组成部分,也不是所有项目必须经过的节点。
- TLS 可能在 CDN、负载均衡器或 Nginx 处终止,不一定一直进入 Spring Boot 应用。
3. 阶段 B:用户点击按钮后,一次 API 请求怎样走完整条链
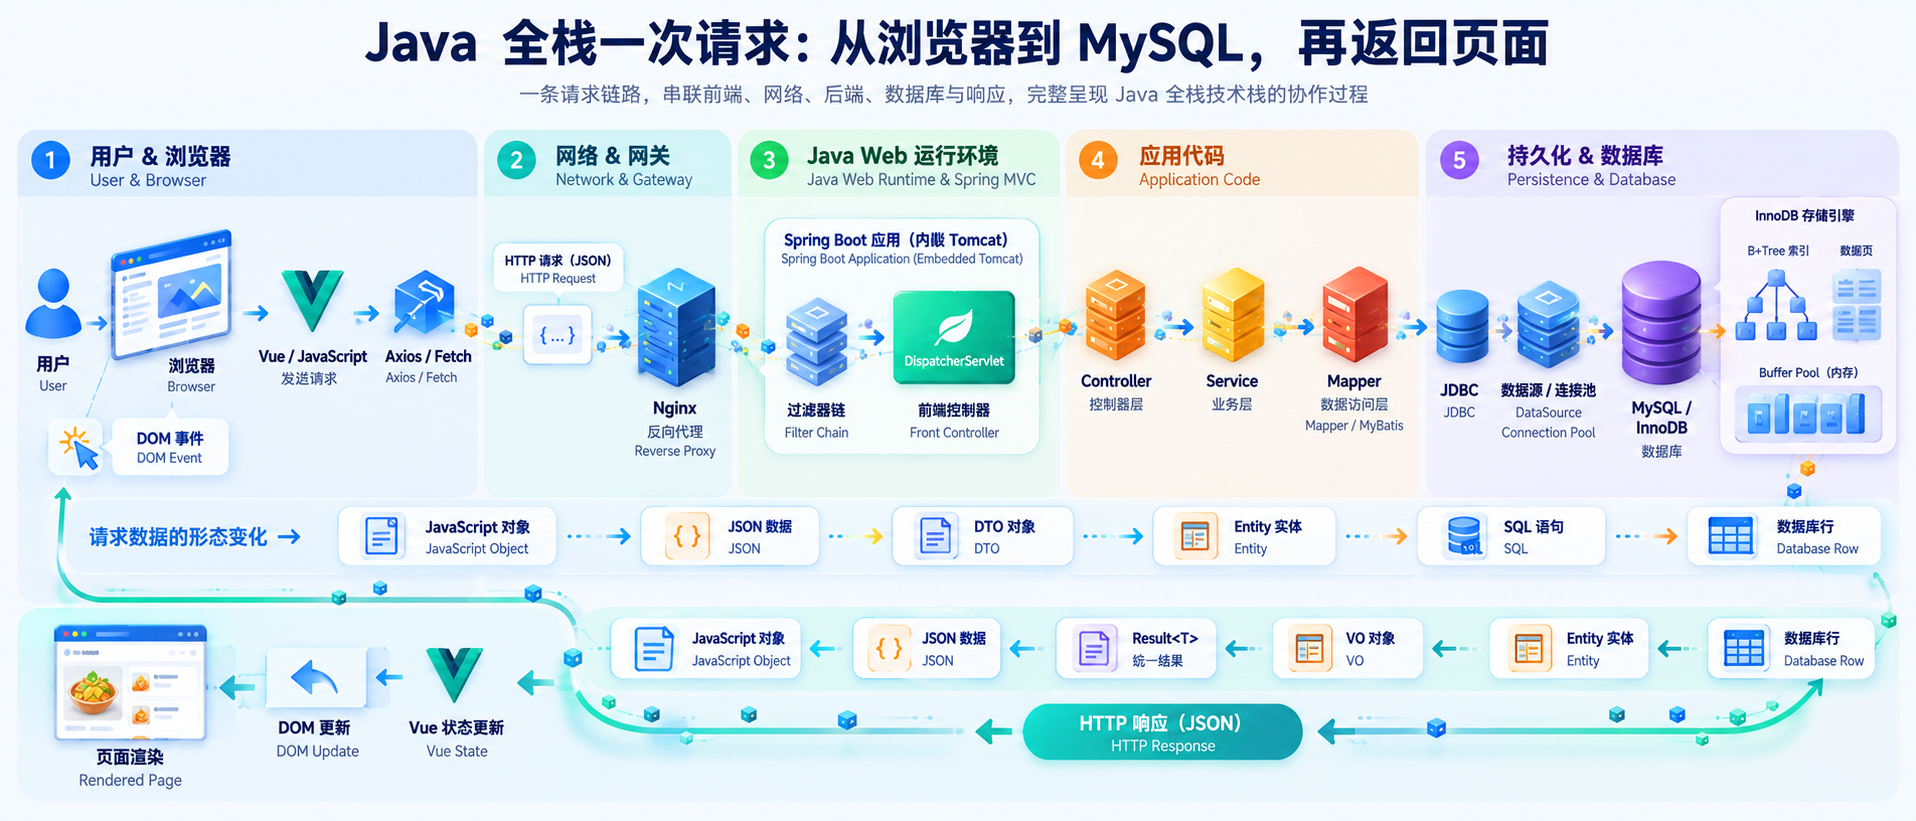
页面已经展示后,用户点击“登录”“保存”“查询”“下单”等按钮,才进入典型的业务请求链。
把它压缩成一条主干:
User
 ↓
DOM Event
 ↓
Vue / JavaScript
 ↓
Axios / Fetch
 ↓
HTTP Request(JSON / Query / Form 等)
 ↓
Nginx
 ↓
Tomcat / Servlet Filter Chain
 ↓
Spring MVC / DispatcherServlet
 ↓
Controller
 ↓
Service
 ↓
Mapper / MyBatis
 ↓
JDBC / DataSource / Connection Pool
 ↓
MySQL
 ↓
Result
 ↓
VO / Result<T>
 ↓
JSON
 ↓
HTTP Response
 ↓
Axios / Fetch
 ↓
Vue State
 ↓
DOM Update
 ↓
User
这就是全文的纵向脊柱。
它是一条“典型请求链”,不是所有请求都会经过所有节点:
- 本地开发可能没有 Nginx;
- 命中 Redis 后可能不访问 MySQL;
- 某些接口只做计算,不访问数据库;
Result<T>是很多项目采用的统一响应包装,并不是 Spring MVC 强制要求;- MQ、WebSocket、Spring Task 属于支线或其他触发模型,而不是普通同步 HTTP 请求的固定节点。
4. 把整条主链压缩成七层
主链虽然很长,但按职责可以压缩成七个层次。
| 层次 | 代表技术 | 核心职责 | | ------------------- | --------------------------------------- | ---------------------------------------- | | ① 用户与前端 | HTML / CSS / JavaScript / Vue / Axios | 收集用户操作、组织页面、调用 API | | ② 网络与 Web 通信 | DNS / TCP / TLS / HTTP / RESTful | 找到服务端、建立通信、定义 API 交互方式 | | ③ 网关入口 | Nginx | 静态资源、反向代理、负载均衡、HTTPS 入口 | | ④ Java Web Runtime | Spring Boot / Tomcat / Servlet / Filter | 让 HTTP 请求进入 Java Web 运行环境 | | ⑤ Web 与业务 | Spring MVC / Controller / Service | 请求映射、参数接收、业务处理 | | ⑥ 持久化 | Mapper / MyBatis / JDBC / HikariCP | 把 Java 数据访问转化为数据库操作 | | ⑦ 数据层 | MySQL / InnoDB | 执行 SQL 并持久化核心业务数据 |
这里有一个容易混淆的点:
RESTful 是 API 设计风格,不是 TCP、TLS 这类网络协议。
把它放在这一层,是因为它参与“前后端如何表达资源和操作”的 API 契约设计。
5. 用户与前端层:把人的操作变成一次 API 调用
前端并不只是“把页面做得好看”,它是业务请求的起点。
- HTML / CSS / JavaScript:分别负责页面结构、视觉表现和交互行为。
- Vue:组织组件、状态与界面更新。
- Axios / Fetch:发送 HTTP 请求并接收响应。
- Vue Router:管理单页应用中的客户端路由。
- Pinia:管理跨组件共享的前端状态。
一次典型操作可以压缩成:
用户点击按钮
 ↓
DOM Event
 ↓
Vue 方法
 ↓
JavaScript Object
 ↓
Axios / Fetch
 ↓
HTTP Request
从这里开始,用户界面中的一次操作已经变成网络可以传输的数据。
6. 网络与 HTTP:让浏览器和服务器真正“说上话”
前端构造好请求后,需要经过网络到达服务器。
- DNS:把域名解析到可访问的地址。
- IP / Port:定位目标主机与具体服务。
- TCP:为 HTTP/1.1、HTTP/2 等提供可靠字节流传输。
- TLS / HTTPS:提供加密、完整性保护与服务端身份验证。
- HTTP:规定 Request / Response 的消息结构和语义。
- RESTful:使用资源、URI、HTTP Method 等组织 API 的一种常见设计风格。
这一层不负责业务,它负责:
让客户端和服务端可以按照约定完成一次可靠、可理解的 Web 通信。
7. Nginx:生产环境常见的系统入口
在很多生产架构里,浏览器不会直接访问 Spring Boot 应用端口,而是先到达 Nginx、云负载均衡器或其他网关节点。
Nginx 常见职责包括:
- 静态资源服务;
- 反向代理;
- HTTPS 入口;
- 负载均衡;
- 压缩、缓存和部分访问控制能力。
可以把它简化理解为:
Browser
   ↓
Nginx
   ├── Static Assets
   └── /api/* → Spring Boot
因此:
Nginx 是常见的系统入口,而不是 Spring MVC 内部组件。
8. Spring Boot、Tomcat 与 Servlet:请求进入 Java 世界
这三个概念经常一起出现,但职责不同。
- Spring Boot:负责应用启动、自动配置、依赖整合和运行环境装配。
- Tomcat:常见的 Servlet 容器,接收 Web 请求并驱动 Servlet 请求处理。
- Servlet / Filter:Java Web 中处理请求、响应和过滤链的基础规范。
可以把关系简化为:
JVM
└── Spring Boot Application
      └── Embedded Tomcat
            └── Servlet / Filter
                  └── Spring MVC
所以:
Spring Boot 更像整个 Java Web 应用的启动与装配环境,而不是一次请求必须依次经过的“业务中转站”。
9. Spring MVC:把 HTTP 请求找到对应的 Controller
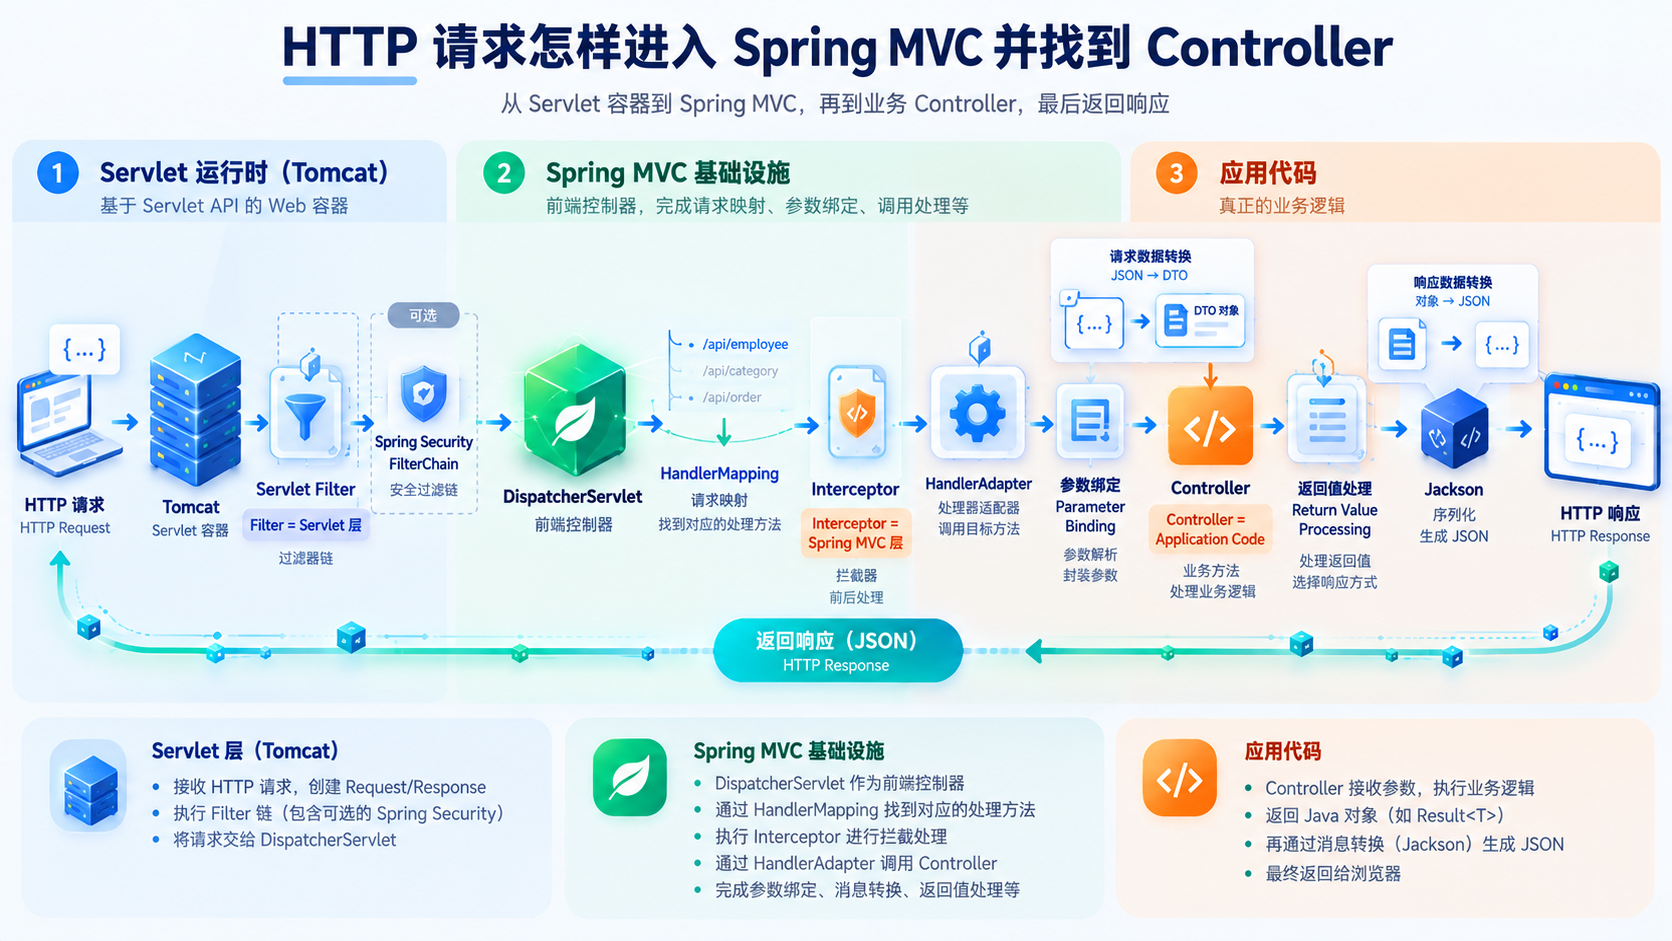
Spring MVC 在整条链路中的核心作用可以压缩成一句话:
把 HTTP Request 映射到对应的 Handler / Controller 方法,再把 Java 返回值转换成 HTTP Response。
总览层面认识这些节点就足够了:
HTTP Request
 ↓
Servlet Filter
 ↓
DispatcherServlet
 ↓
HandlerMapping
 ↓
Handler / Interceptors
 ↓
HandlerAdapter
 ↓
Parameter Binding / HttpMessageConverter / Jackson
 ↓
Controller
 ↓
Return Value Processing
 ↓
HTTP Response
它们的职责可以快速记成:
- DispatcherServlet:Spring MVC 的 Front Controller,负责统一调度。
- HandlerMapping:根据请求找到对应 Handler,并关联相应 Interceptor。
- Interceptor:在 MVC Handler / Controller 前后执行统一处理。
- HandlerAdapter:让 DispatcherServlet 能以统一方式调用不同类型的 Handler。
- 参数绑定 / HttpMessageConverter / Jackson:把 HTTP 中的数据转成 Java 参数,或把 Java 返回值转成响应体。
- 异常解析机制:把请求处理过程中的异常转换成合适的错误响应。
这里不继续追踪框架内部类层级,因为那属于 Spring MVC 专题,而不是全链路地图的主角。
10. Java 后端主干:Controller → Service → Mapper
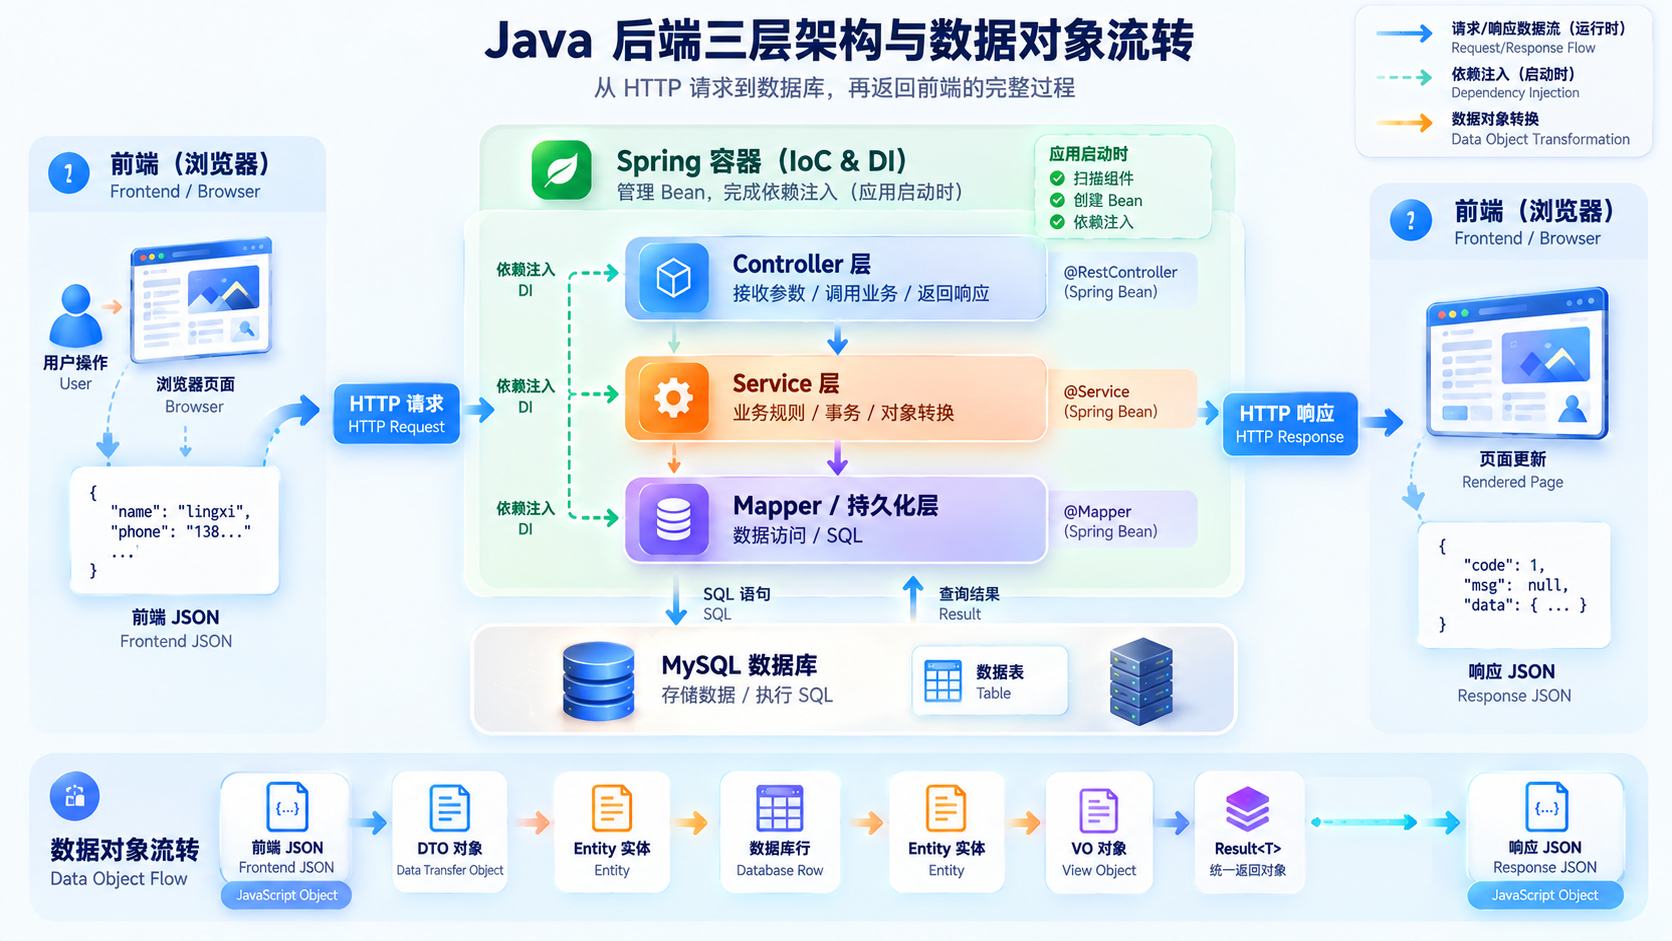
Spring MVC 完成请求映射后,真正进入我们编写的应用代码。
Controller
   ↓
Service
   ↓
Mapper
10.1 Controller:Web 接口层
作用:接收参数、调用业务、返回响应。
常见注解:
@RestController
@RequestMapping
@GetMapping / @PostMapping / @PutMapping / @DeleteMapping
@RequestBody / @RequestParam / @PathVariable
@Valid / @Validated
基本规范:
Controller 尽量只做“接收 → 调用 → 返回”,复杂业务规则交给 Service。
10.2 Service:业务层
作用:承载业务规则,组织一个完整业务过程。
常见内容:
@Service
@Transactional
DTO → Entity
Entity → VO
Business Logic
基本规范:
Service 关注业务过程与事务边界,不关心 HTTP 细节,也不承担 SQL 映射职责。
10.3 Mapper:数据访问层
作用:负责应用程序与数据库之间的数据访问。
以 MyBatis 为例,常见内容:
@Mapper
Mapper Interface
Mapper XML / SQL Annotation
#{ } 参数绑定
resultType / resultMap
Dynamic SQL
基本规范:
Mapper 负责数据访问,不负责业务规则。
11. DTO、Entity、VO:同一份业务数据在不同边界上的表达
三层架构不仅在传递“值”,也在不断改变数据的表达形式。
一种常见建模方式是:
Frontend JSON
  ↓
DTO:接收请求数据
  ↓
Controller / Service
  ↓
Entity:业务 / 持久化实体
  ↓
Mapper / Database

Database
  ↓
Entity
  ↓
Service
  ↓
VO:组织前端需要的数据
  ↓
Result<T>(可选的统一响应包装)
  ↓
JSON Response
真正需要掌握的是边界意识:
- DTO:常用于输入或跨层传输;
- Entity:常用于表达业务实体或持久化数据;
- VO:常用于面向前端输出;
- Result<T>:很多项目用它统一包装
code / message / data,但它是项目约定,不是 Spring 强制模型。
这些并不是不可改变的硬规则。不同项目可以有不同命名和建模方式,但“不要让所有边界无条件共用同一个对象”的工程思想很重要。
12. IoC / DI 在哪里:它不是请求节点,而是应用的组织方式
在代码里:
Controller 需要 Service
Service 需要 Mapper
这些对象通常不会由业务代码到处手动 new,而是由 Spring Container 管理和装配。
Class
 ↓
Spring Container
 ↓
Bean
 ↓
Dependency Injection
 ↓
Controller / Service / Mapper 协作
常见相关注解包括:
@Component
@RestController
@Service
@Repository
@Configuration
@Bean
@Autowired
现代 Spring 项目通常更偏向 Constructor Injection;当类只有一个构造器时,也不一定需要显式写 @Autowired。
因此:
IoC / DI 更适合画在三层架构背后的“组织层”,而不是强行插入一次请求的运行箭头中。
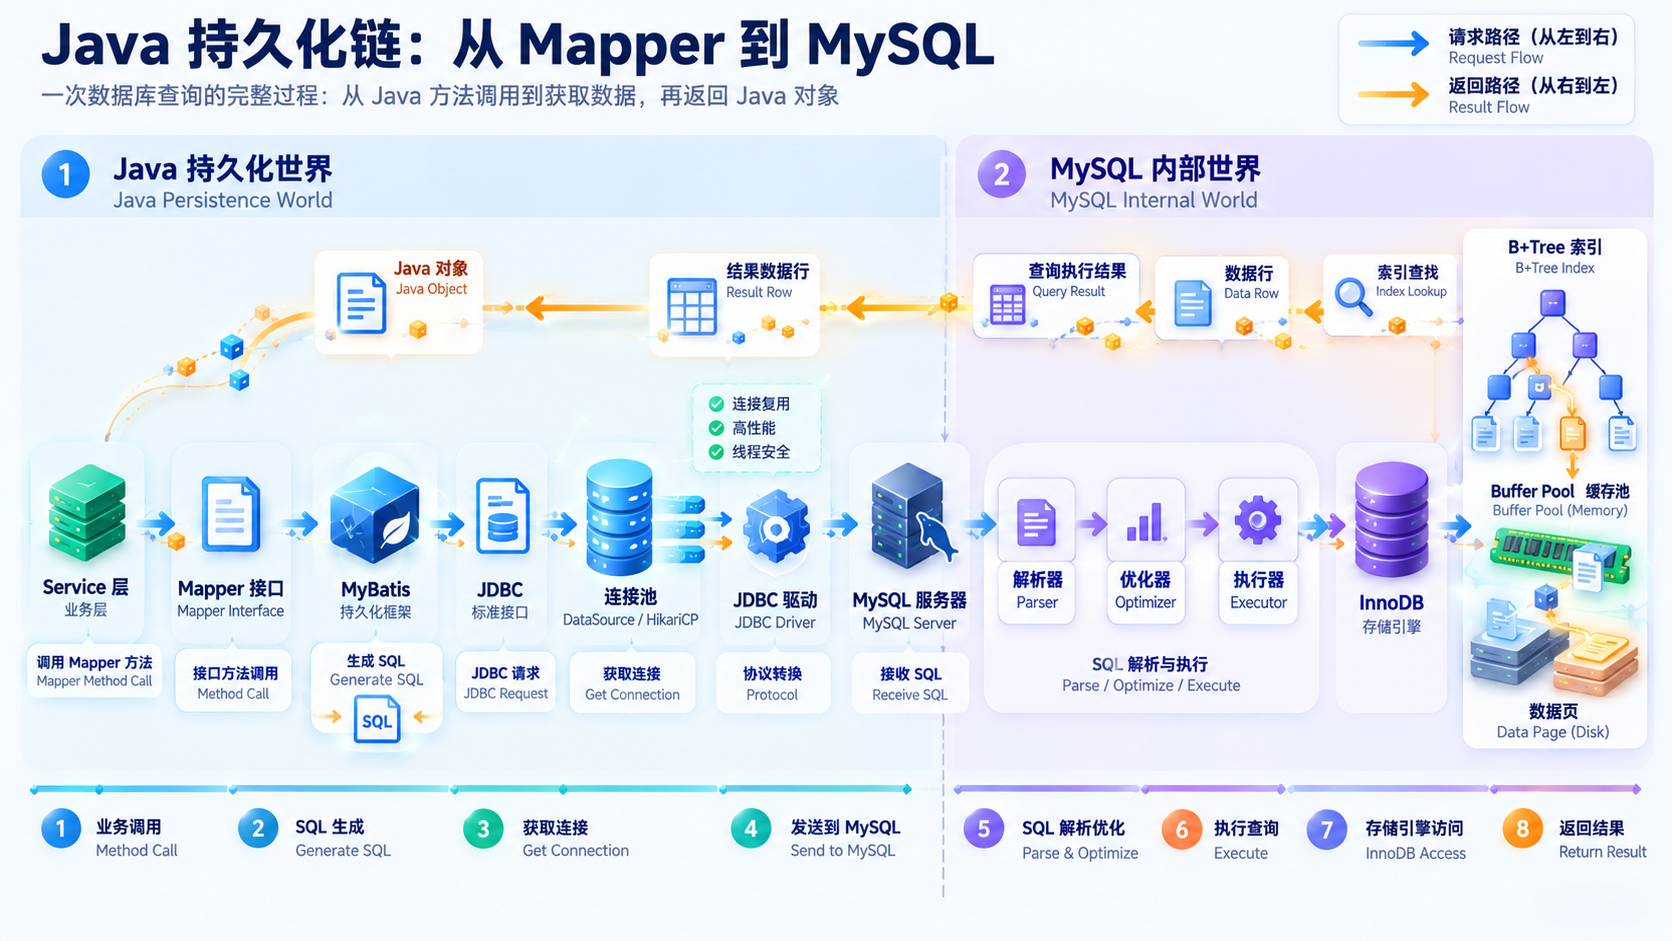
13. Mapper 到 MySQL 之间,还有一条持久化链
Mapper → MySQL 是教学上的压缩写法。
在典型 MyBatis 项目中,更接近:
Service
 ↓
Mapper Interface
 ↓
MyBatis
 ↓
JDBC
 ↓
DataSource / Connection Pool(常见如 HikariCP)
 ↓
JDBC Driver
 ↓
MySQL Server
 ↓
InnoDB
每个节点只需要一句话理解:
- MyBatis:根据 Mapper 映射定位并执行 SQL,把参数交给 JDBC,并把结果集映射回 Java 对象。
- JDBC:Java 访问关系型数据库的标准 API。
- DataSource / Connection Pool:管理和复用数据库连接,避免每次请求都重新建立数据库连接。
- JDBC Driver:实现 JDBC 调用与 MySQL 通信之间的具体适配。
- MySQL Server:接收 SQL,并完成解析、优化和执行等工作。
- InnoDB:MySQL 常用的默认存储引擎,负责索引、数据页、事务和并发控制等核心能力。
为了理解项目位置,可以把数据库内部进一步抽象为:
SQL
 ↓
Parser / Optimizer / Executor
 ↓
InnoDB
 ↓
Index / Buffer Pool / Data Page
因此我们平时学习的索引、B+Tree、事务、MVCC、锁、Redo / Undo Log、Buffer Pool,并不是项目之外的一套孤立知识,而是位于整条链最后的“数据库内部”。
14. 另一条隐藏主线:数据本身一直在“变形”
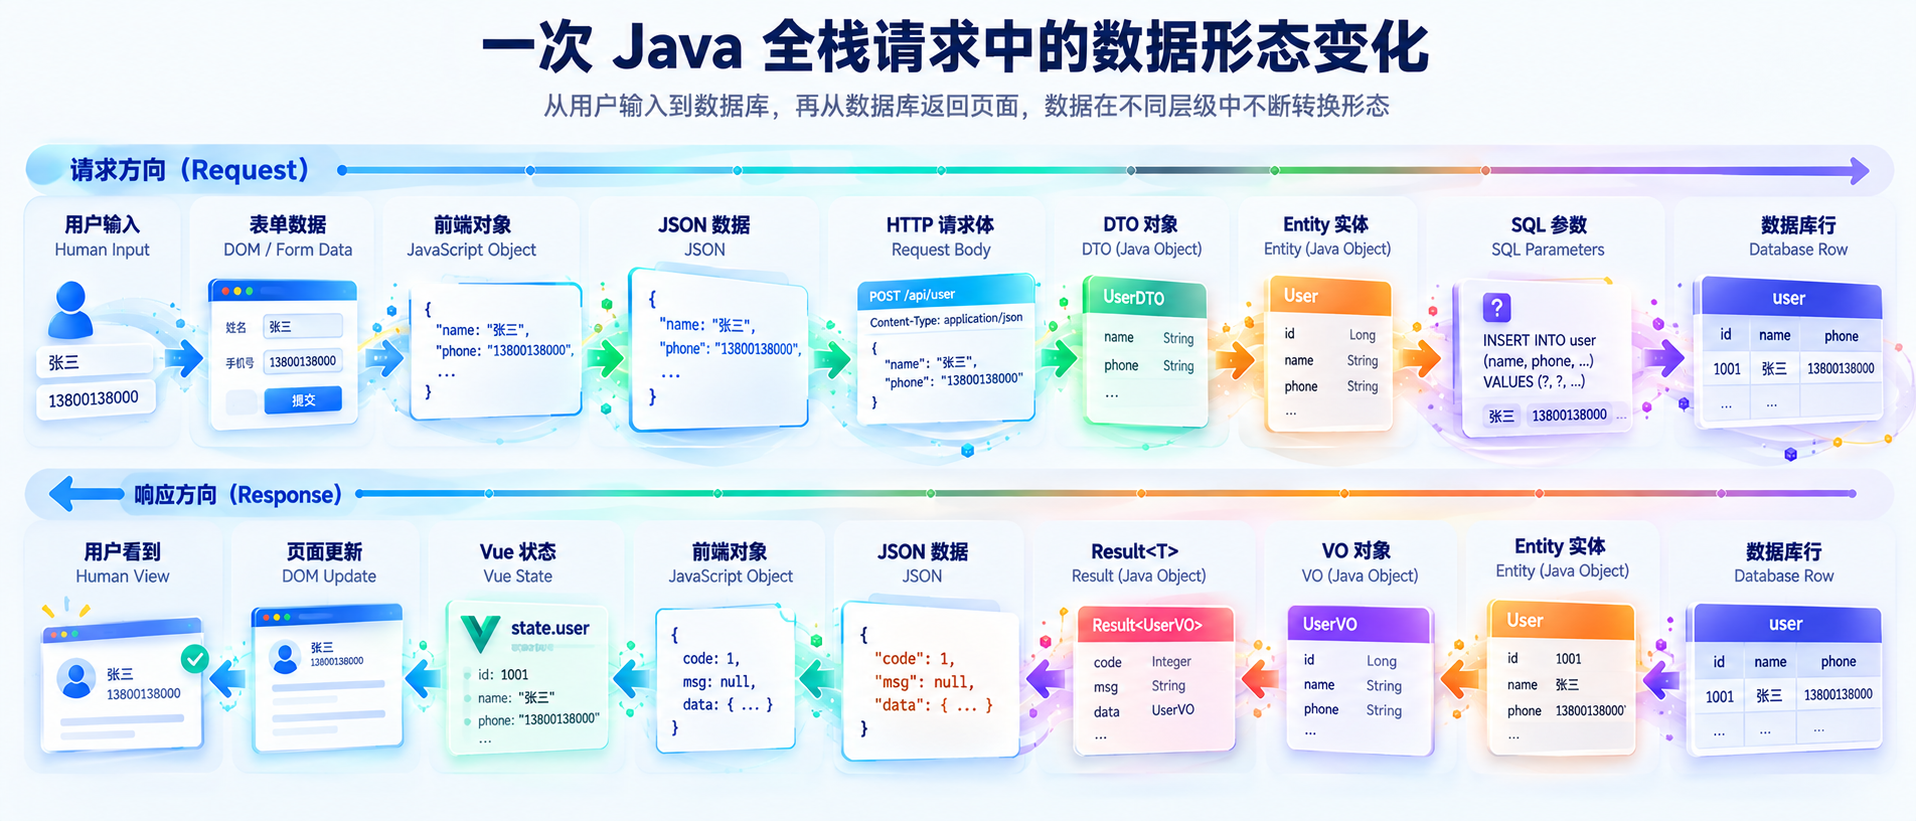
如果前面的主链关注“请求经过谁”,还有另一条同样重要的链关注:
同一份业务信息,在不同系统边界上以什么形式存在。
一次典型的数据变化可以抽象成:
用户输入
 ↓
DOM / Form Data
 ↓
JavaScript Object
 ↓
JSON
 ↓
HTTP Request Body
 ↓
DTO
 ↓
Entity
 ↓
SQL Parameters
 ↓
Database Row
 ↓
Entity
 ↓
VO / Result<T>
 ↓
JSON
 ↓
JavaScript Object
 ↓
Vue State
 ↓
DOM
 ↓
用户看到结果
当然,并不是所有接口都会完整经历这组转换。
例如:
- GET 查询可能没有 JSON Request Body;
- Service 可能直接返回 DTO / projection;
- 项目也可能不用统一
Result<T>; - ORM / 持久化方案不同,对象边界也会不同。
但这条数据线揭示了一个很重要的事实:
DTO、Entity、VO、JSON、SQL、Database Row,本质上是在描述同一份业务信息跨越不同边界时的不同表达形式。
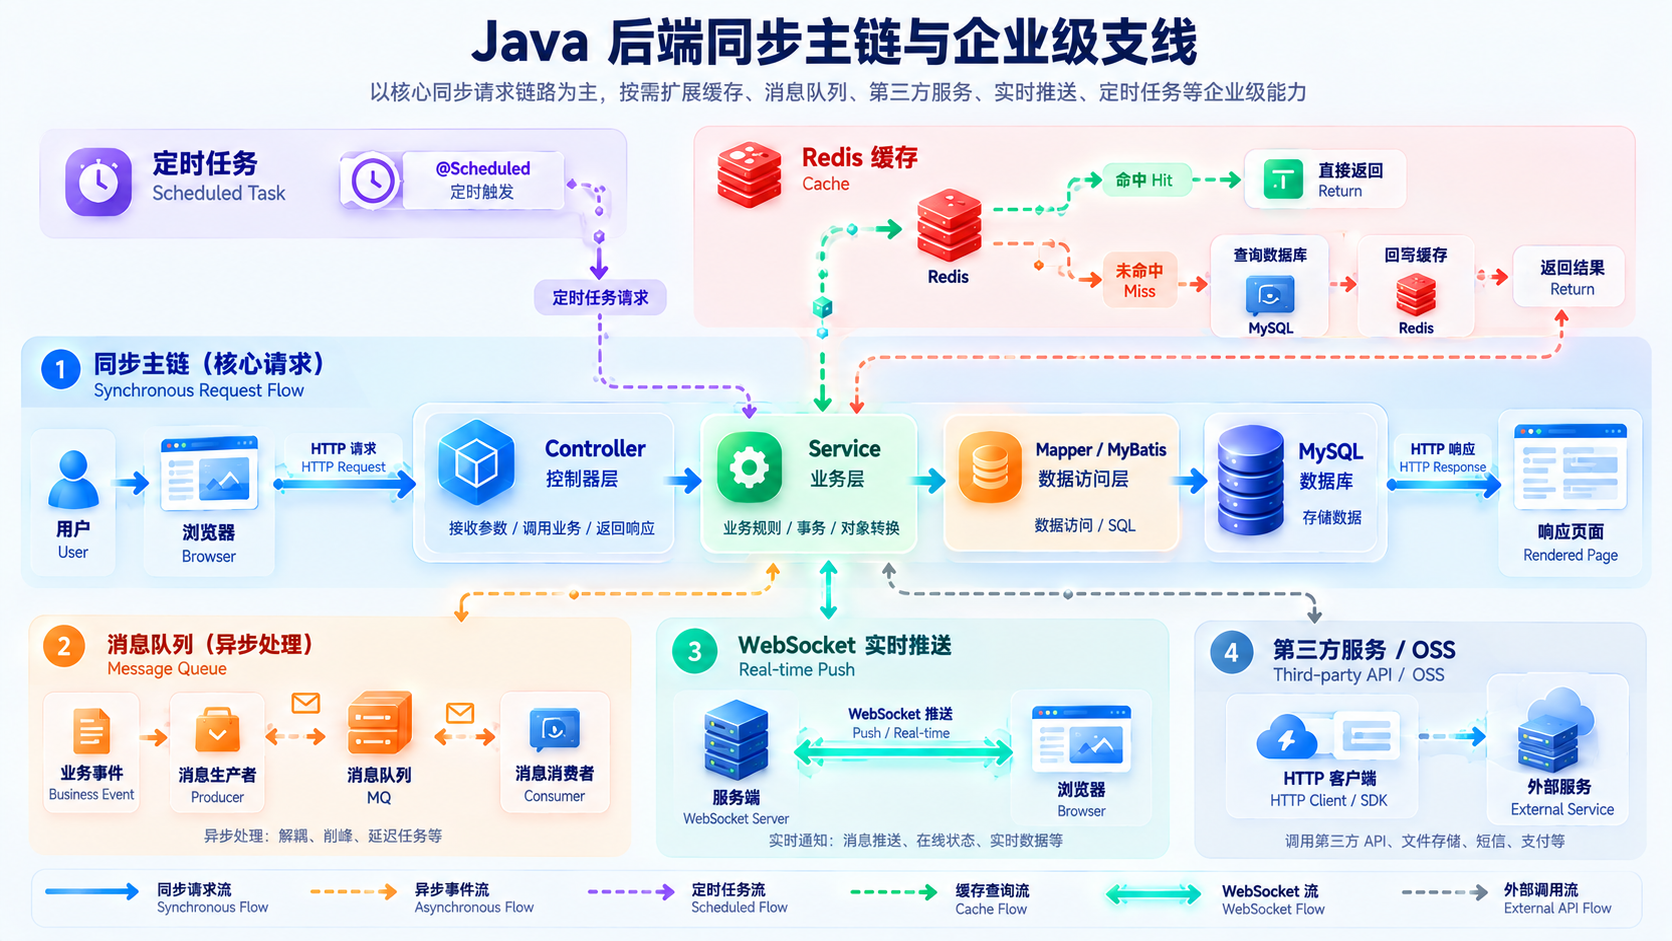
15. 主链之外:企业项目为什么会出现 Redis、MQ、WebSocket、Task
到这里,同步主链已经完整:
Browser → Java Backend → Database → Browser
但真实业务不会只有同步 CRUD,因此还会出现一些支线能力。
它们很重要,却不是每个请求都必经。
15.1 Redis:缓存支线
以典型的读取型 Cache-Aside 为例:
Service
 ↓
Redis
 ├─ Hit  → Return
 └─ Miss → MySQL → Cache Redis → Return
作用: 缓存热点数据,减少重复数据库访问,提高读取性能。
常见关联知识:
TTL
Spring Cache
Cache Aside
缓存穿透 / 击穿 / 雪崩
数据一致性
分布式锁
缓存更新策略与一致性方案会随业务而变化,因此“数据库更新后一定怎样写 Redis”不能用一条规则概括。
15.2 MQ:异步支线
Business Event
 ↓
Producer
 ↓
Message Broker / Queue / Topic
 ↓
Consumer
作用: 把适合异步执行的工作从同步请求中拆出去,用于解耦、削峰和后台处理。
常见技术:
RabbitMQ
Kafka
RocketMQ
常见关联知识:
Producer / Consumer
Queue / Topic
ACK
Retry
Dead Letter
Idempotency
消息可靠性
15.3 WebSocket:实时通信支线
Browser ←──── Persistent Bidirectional Connection ────→ Server
作用: 建立持续的双向通信通道,使服务器可以主动向客户端推送实时消息。
常见场景:
来单提醒
聊天
实时状态
通知
数据大屏
15.4 Spring Task:时间驱动入口
并不是所有业务都从用户 HTTP Request 开始。
Clock / Scheduler
 ↓
@Scheduled
 ↓
Service
作用: 按时间规则自动触发业务逻辑。
常见场景:
超时订单
日报
数据清理
定时通知
15.5 第三方 API / OSS:跨系统能力
Service
 ↓
HTTP Client / SDK
 ↓
External Service
作用: 让自己的系统接入支付、微信登录、短信、地图、对象存储等外部能力。
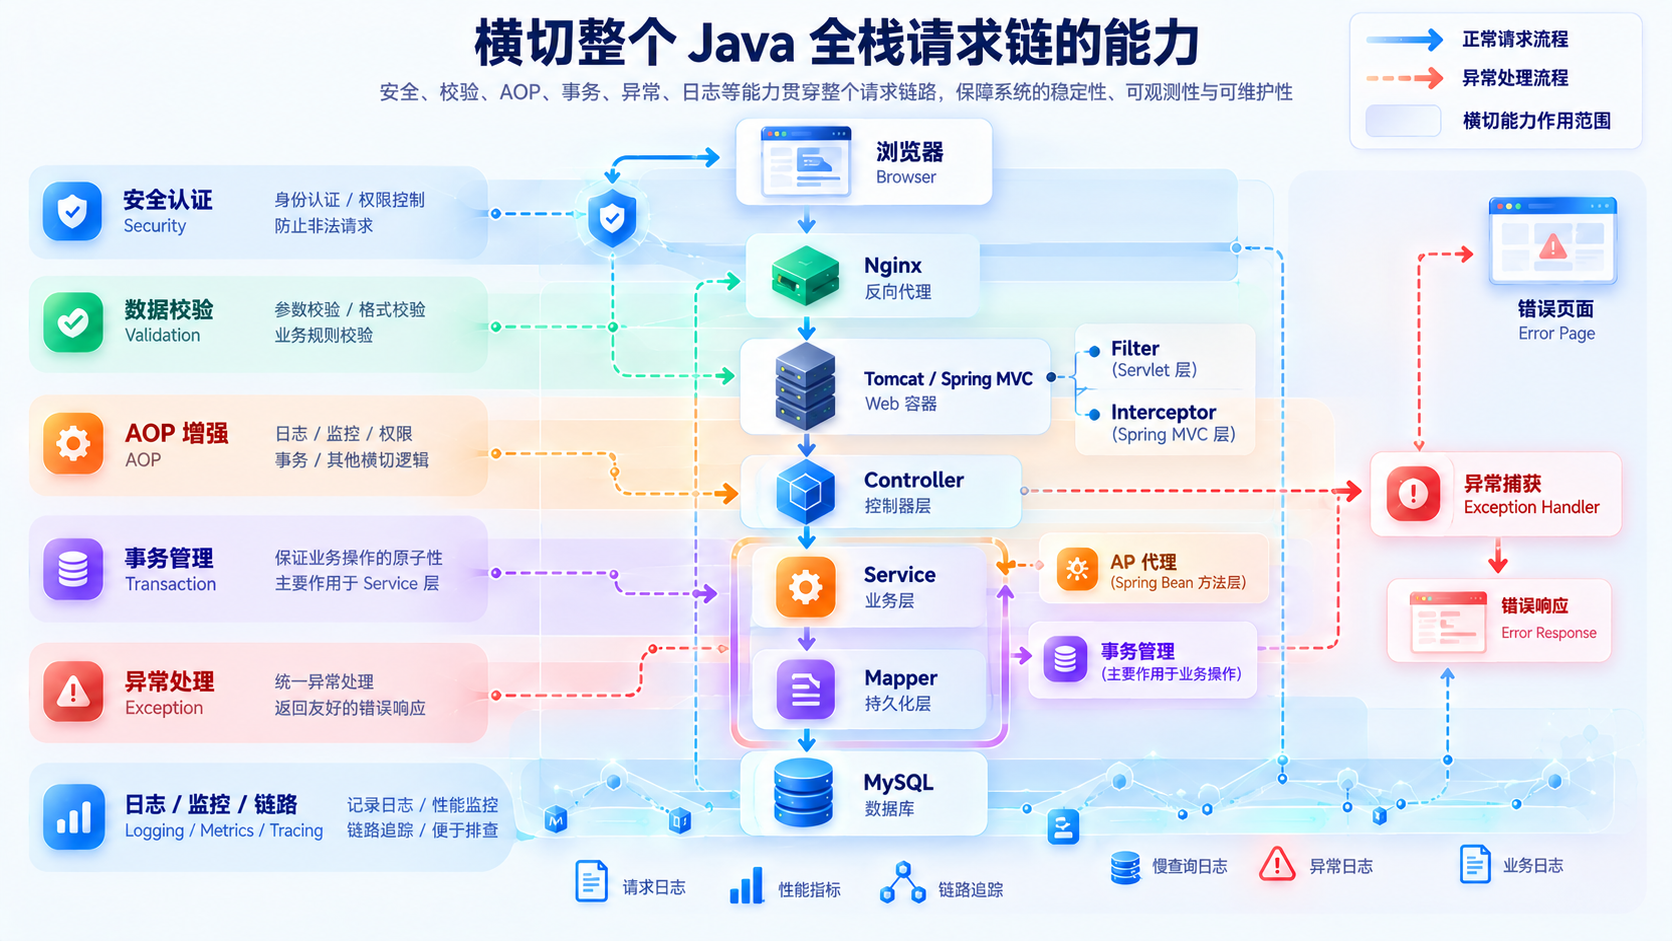
16. 横切整条链路的能力
还有一类能力很特殊:它们不属于某一个固定业务节点,而是会覆盖一段甚至整条链路。
| 横切能力 | 主要作用 | 常见实现 |
| ------------------------------ | ------------------------------------ | -------------------------------------------- |
| Authentication / Authorization | 判断“你是谁、你能做什么” | Spring Security、JWT、RBAC |
| Validation | 在核心业务执行前校验输入 | Bean Validation、@Valid、@Validated |
| Transaction | 让一组数据库操作按事务边界提交或回滚 | @Transactional、TransactionManager |
| AOP | 对 Spring Bean 方法统一增强 | Logging、Audit、Transaction 等 |
| Exception Handling | 把异常统一转换成 API 错误响应 | @RestControllerAdvice、@ExceptionHandler |
| Observability | 记录、测量并追踪运行过程 | Logging、Metrics、Tracing |
16.1 Filter、Interceptor、AOP 的位置区别
与其背定义,不如直接看它们在哪一层。
HTTP Request
 ↓
Filter                ← Servlet 层
 ↓
DispatcherServlet
 ↓
Interceptor           ← Spring MVC 层
 ↓
Controller / Service
 ↓
AOP Proxy             ← Spring Bean 方法层
可以快速记成:
- Filter:包围 Servlet 请求链;
- Interceptor:包围 Spring MVC Handler / Controller;
- AOP:增强 Spring Bean 方法调用。
在完整的 Spring Security Servlet 架构中,安全处理通常建立在 Servlet Filter Chain 之上。
事务则通常在 Service 业务边界开启,通过同一个事务上下文覆盖后续一组数据库操作;从概念图上可以画成包围 Service → Mapper → Database Operation 的事务范围,但真正的数据库事务最终落实在数据库连接和数据库引擎上。
17. 从代码到线上:工程能力包围整个项目
一次 HTTP Request 的运行流程,并不等于完整的软件工程。
一个项目还需要从“能运行”继续走向“可构建、可测试、可部署、可观察、可维护”。
| 工程域 | 代表技术 | 作用 | | --------------- | ----------------------------------------------- | -------------------- | | Build | Maven、Dependency、Multi-module、JAR | 依赖管理、构建与打包 | | Version Control | Git、Branch、Merge、GitHub / Gitee | 代码版本与协作 | | API & Test | OpenAPI / Swagger、Apifox、Postman、JUnit | 接口文档、测试与联调 | | Runtime | JVM、Linux、Process、Port、Environment Variable | 提供真实运行环境 | | Deployment | Nginx、JAR、Docker | 部署与运行应用 | | Delivery | CI/CD | 自动构建、测试与发布 | | Production | Logging、Metrics、Tracing、Backup | 线上观测、维护与恢复 |
其中 Docker、CI/CD 等都不是 Java 项目运行的必要条件,它们属于现代工程中常见的交付方案。
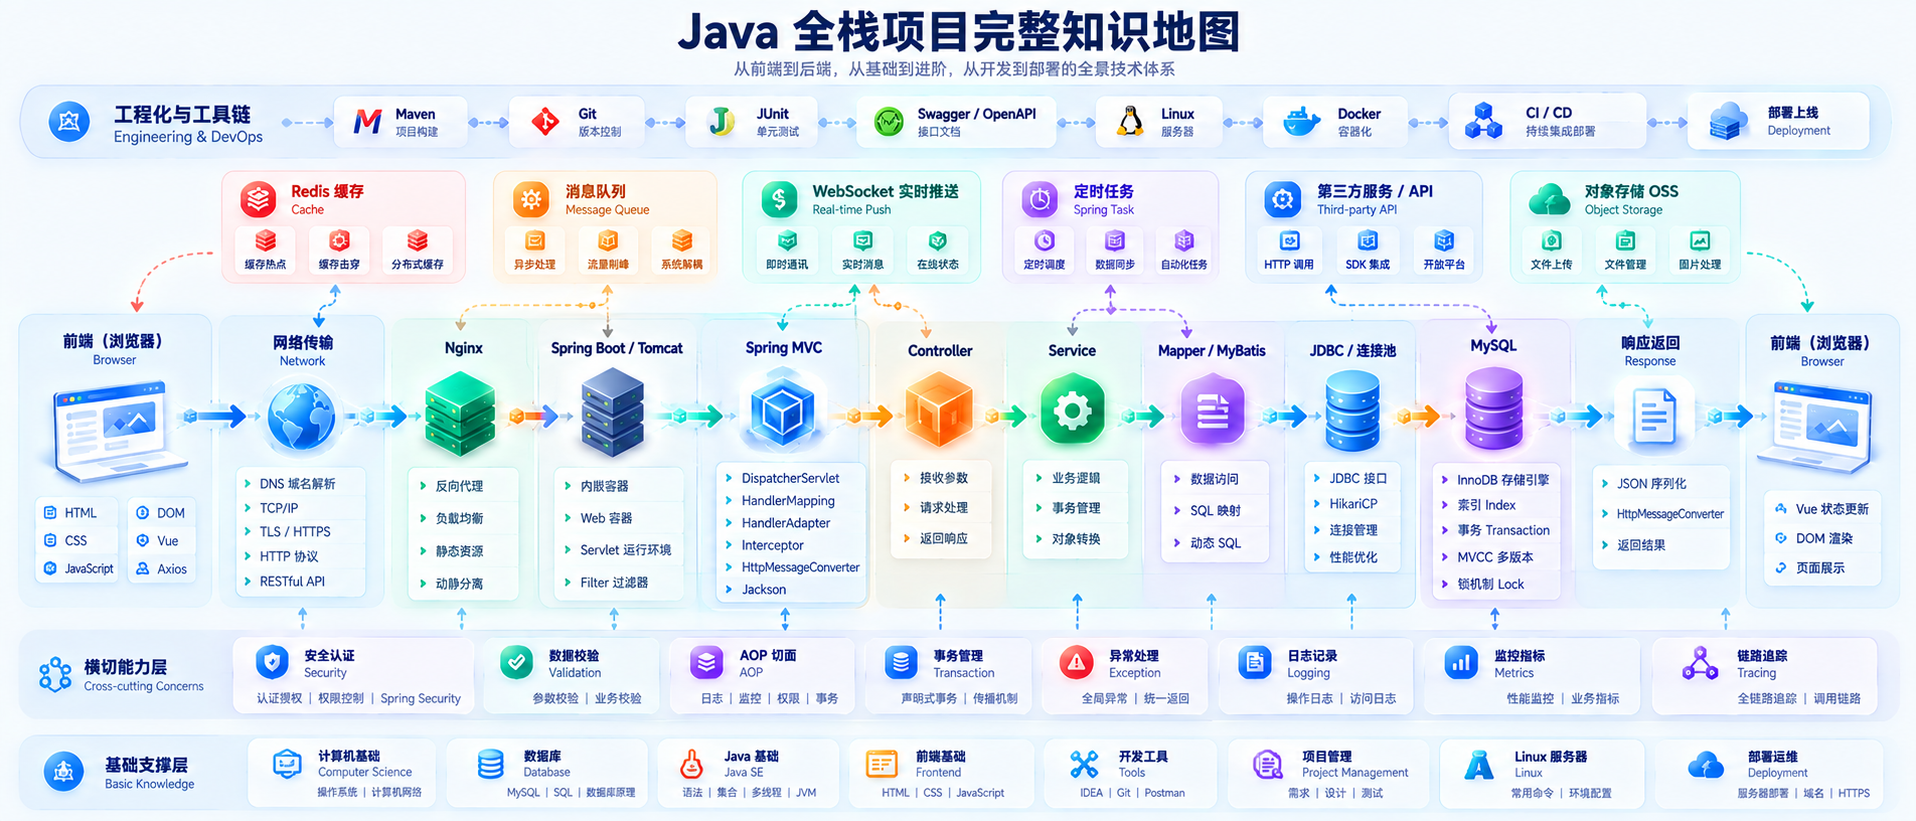
18. 最终把所有内容压缩成一张 Java 全栈地图
到这里,可以把全文重新组织成一棵树:
Java 全栈项目
│
├── 用户与前端
│   ├── Browser / URL
│   ├── HTML / CSS / JavaScript / DOM
│   └── Vue / Axios / Router / Pinia
│
├── 网络与 Web 通信
│   ├── DNS / IP / Port
│   ├── TCP / QUIC
│   ├── TLS / HTTPS
│   └── HTTP / RESTful API
│
├── 网关
│   └── Nginx / Load Balancer / CDN
│
├── Java Web Runtime
│   ├── Spring Boot
│   ├── Tomcat
│   └── Servlet / Filter
│
├── Spring MVC
│   ├── DispatcherServlet
│   ├── HandlerMapping / HandlerAdapter
│   ├── Interceptor
│   ├── Parameter Binding
│   ├── HttpMessageConverter / Jackson
│   └── Exception Handling
│
├── Application Code
│   ├── Controller
│   ├── Service
│   ├── Mapper
│   ├── DTO / Entity / VO
│   └── IoC / DI / AOP / Transaction
│
├── Persistence
│   ├── MyBatis
│   ├── JDBC
│   └── DataSource / Connection Pool
│
├── Data
│   ├── MySQL / InnoDB
│   └── Redis
│
├── Async / Realtime / Scheduled
│   ├── MQ
│   ├── WebSocket
│   └── Spring Task
│
├── Cross-cutting
│   ├── Spring Security / JWT / RBAC
│   ├── Validation
│   ├── Exception
│   └── Logging / Metrics / Tracing
│
└── Engineering
    ├── Maven
    ├── Git
    ├── OpenAPI / Apifox
    ├── JUnit
    ├── Linux
    ├── Docker
    ├── CI/CD
    └── Deployment / Monitoring
这张树真正想表达的不是“还要背这么多名词”,而是:
每一种技术都有自己的位置。只要知道当前位于哪一层,就能顺着上下游继续理解整个系统。
19. 回到最开始的问题:一次点击,到底发生了什么?
现在再回到最开始的那次点击。
用户看到的可能只是:
点击“保存”
系统看到的却是:
用户操作
 ↓
前端事件
 ↓
JavaScript 数据
 ↓
HTTP Request
 ↓
网络传输
 ↓
Nginx
 ↓
Tomcat / Servlet
 ↓
Spring MVC
 ↓
Controller
 ↓
Service
 ↓
Mapper / MyBatis
 ↓
JDBC
 ↓
MySQL
 ↓
结果返回
 ↓
JSON
 ↓
Vue State
 ↓
DOM 更新
 ↓
用户看到新的页面状态
与此同时,系统还可能:
- 先从 Redis 获取缓存;
- 把业务事件投递给 MQ;
- 通过 WebSocket 主动推送实时消息;
- 由 Spring Task 在没有用户请求时触发后台任务;
- 通过 Spring Security 完成认证与授权;
- 用事务保证一组数据库操作的一致性;
- 通过统一异常处理返回稳定的 API 错误结构;
- 用 Logging、Metrics、Tracing 观察一次请求从进入到结束的全过程。
这就是 Java 全栈真正有意思的地方:
看似分散的框架、协议、中间件和工程工具,其实都在为同一个业务系统的不同边界负责。
以后再遇到一个新技术,不妨先问三个问题:
- 它位于整条链的哪里?
- 它在这里解决什么问题?
- 它的上游和下游分别是谁?
当这三个问题能够回答出来,Java 全栈就不再是一堆孤立名词,而是一张可以在脑中自由移动的工程地图。